Setor público lidera governança de informações, mas aparece na última posição em acesso aos próprios dados; fragmentação, sistemas isolados e baixa integração podem limitar investimentos em inteligência artificial.
A corrida dos governos pela inteligência artificial esbarra em um problema anterior aos algoritmos, modelos de linguagem e capacidade computacional: conseguir localizar, acessar e conectar os próprios dados. Levantamento internacional da Cloudera mostra que o setor público é, entre os segmentos pesquisados, o que apresenta maior nível de governança das informações, mas, paradoxalmente, também é o que registra a menor capacidade de acessar integralmente seus dados.
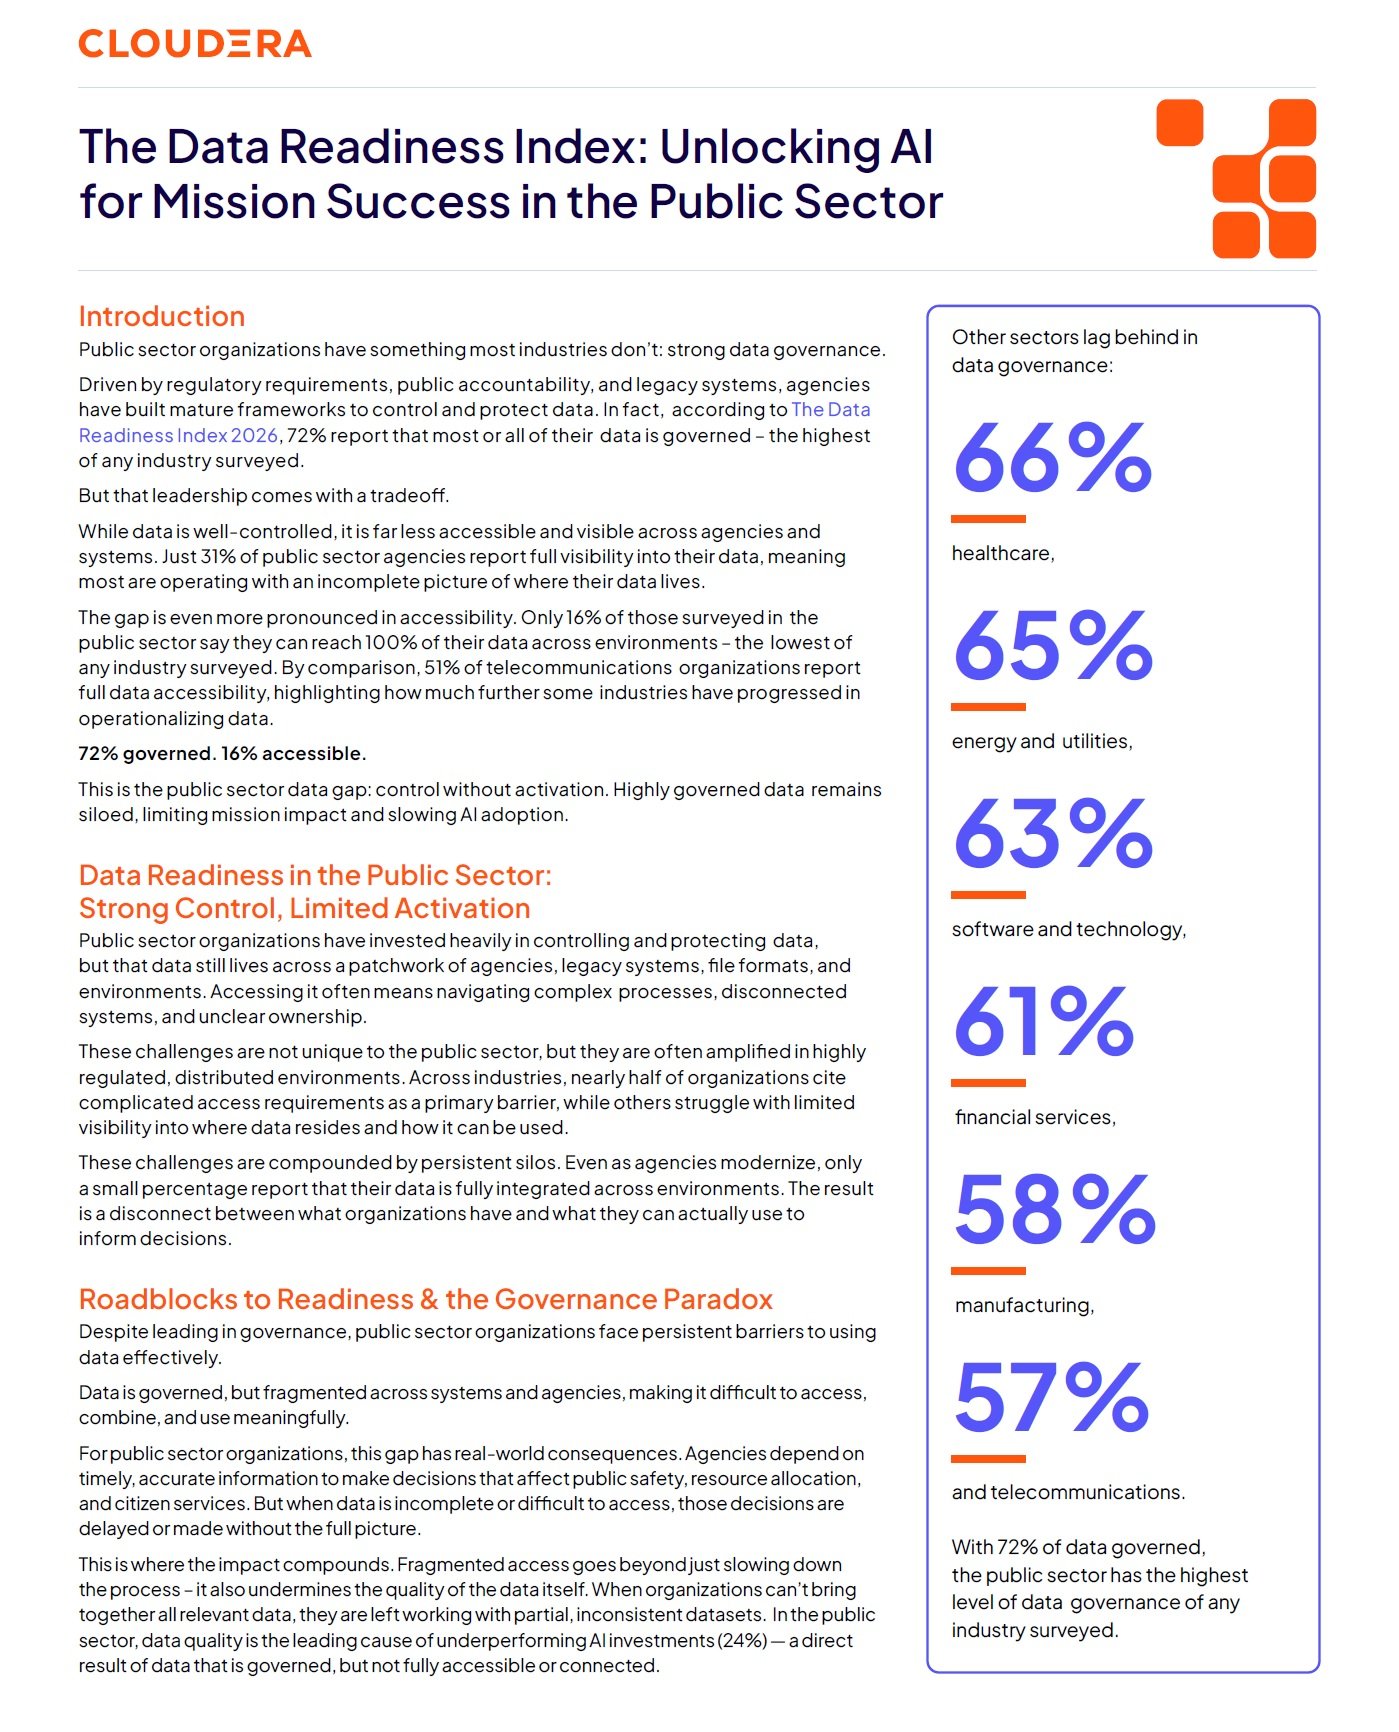
Segundo o Data Readiness Index 2026, 72% das organizações governamentais e do setor público afirmam que a maior parte ou a totalidade de seus dados está sob governança, percentual superior ao registrado em saúde, com 66%, energia e utilities, com 65%, software e tecnologia, com 63%, serviços financeiros, com 61%, manufatura, com 58%, e telecomunicações, com 57%.
Mas quando a questão deixa de ser o controle e passa a ser a capacidade de efetivamente utilizar essas informações a posição se inverte. Apenas 16% dos entrevistados do setor público dizem conseguir acessar 100% dos dados da organização, independentemente do ambiente ou formato. É o menor percentual entre os setores pesquisados. Em telecomunicações, por exemplo, 51% afirmam possuir essa capacidade.
O documento específico produzido pela Cloudera sobre o setor público resume o problema em dois números: 72% dos dados governados e apenas 16% plenamente acessíveis. A empresa chama essa diferença de “public sector data gap”, uma espécie de lacuna de dados do setor público caracterizada por “controle sem ativação”. As informações estão protegidas e submetidas a regras de governança, mas continuam dispersas e difíceis de utilizar.
O problema coloca em discussão uma etapa anterior à própria contratação ou desenvolvimento de sistemas de inteligência artificial. Antes de fazer a IA trabalhar sobre as informações governamentais, os órgãos precisam saber onde essas informações estão, ter autorização e capacidade técnica para acessá-las e conseguir combinar bases mantidas em diferentes sistemas e ambientes tecnológicos.
A pesquisa mostra que somente 31% das organizações do setor público afirmam ter visibilidade completa sobre onde seus dados estão armazenados. Isso significa que, mesmo em organizações que desenvolveram mecanismos relativamente avançados para controlar e proteger informações, existe dificuldade para enxergar o conjunto do patrimônio de dados disponível.
A situação é agravada pela fragmentação tecnológica. O relatório descreve um ambiente no qual informações permanecem distribuídas por diferentes órgãos, sistemas legados, formatos de arquivos e infraestruturas, enquanto o acesso depende de processos complexos e sistemas desconectados.
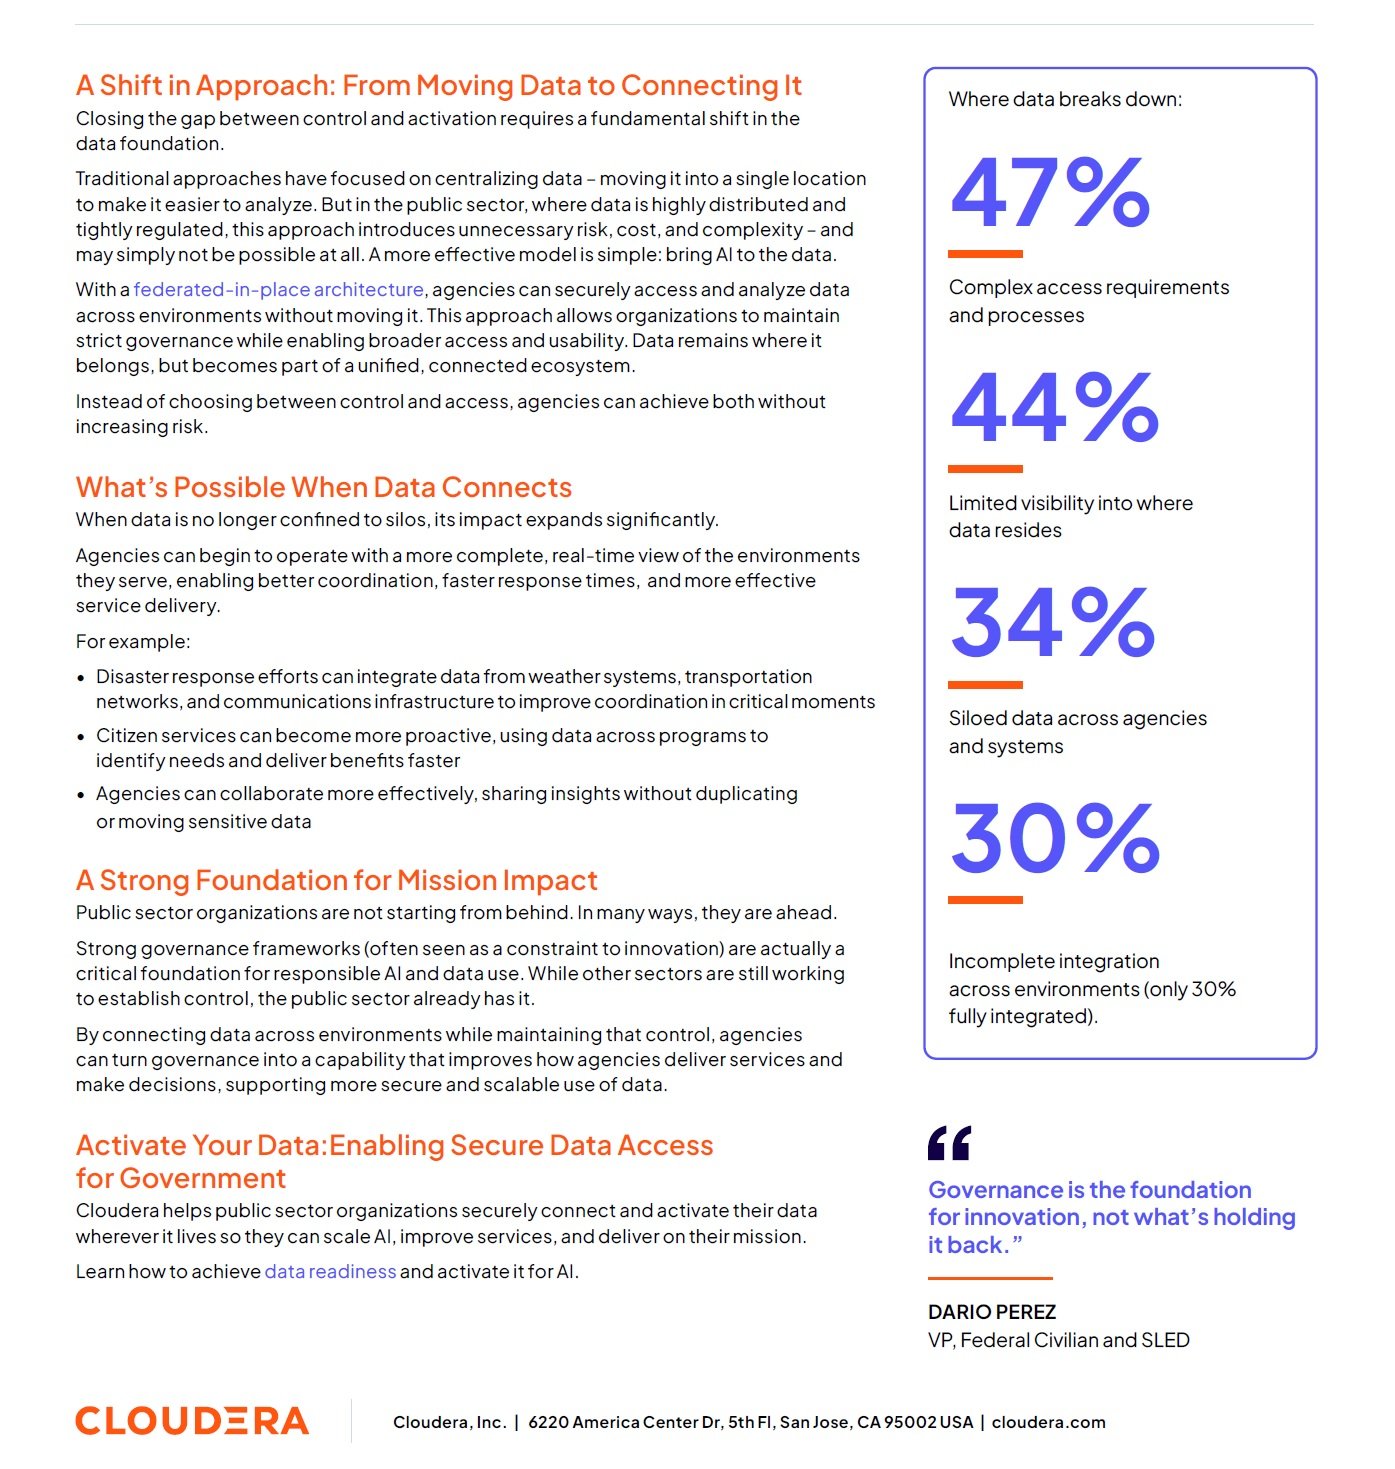
Os números ajudam a dimensionar o problema. Requisitos e processos complicados de acesso aos dados são apontados por 47% como uma barreira. Outros 44% mencionam a dificuldade de saber onde os dados estão localizados, enquanto 34% apontam a existência de informações isoladas entre diferentes órgãos e sistemas. No final dessa cadeia aparece outro número importante: apenas 30% dizem possuir integração completa dos dados entre diferentes ambientes.
Impacto na IA
A consequência pode chegar diretamente aos projetos de inteligência artificial. No setor público, 24% dos entrevistados apontaram problemas de qualidade dos dados como a principal razão para investimentos em IA apresentarem resultados abaixo do esperado. Software e tecnologia registraram 30% nesse indicador e telecomunicações, 22%.
O diagnóstico sugere que parte da discussão sobre inteligência artificial no governo pode estar começando pelo final. Modelos mais sofisticados e maior capacidade de processamento não resolvem necessariamente o problema quando as informações que deveriam alimentar esses sistemas permanecem espalhadas, inacessíveis ou incompletas.
A própria definição de prontidão de dados utilizada no estudo ajuda a explicar essa diferença. Para a Cloudera, não basta uma organização possuir grandes volumes de informações. Ela precisa ser capaz de governar, acessar, integrar e confiar nesses dados independentemente do ambiente em que estejam armazenados para que possam ser utilizados por IA, análise de dados e processos de tomada de decisão.
O levantamento geral reforça a dimensão do problema, considerando que em todos os setores pesquisados, 79% dos entrevistados disseram que iniciativas baseadas em dados são prejudicadas, porque suas organizações não conseguem acessar 100% das informações necessárias nos diferentes ambientes. Ao mesmo tempo, 85% acreditam possuir uma estratégia de dados claramente definida.
É justamente no setor público que essa contradição ganha contornos particulares. Governos precisam preservar informações protegidas por regras legais, administrativas e de segurança, ao mesmo tempo em que necessitam combinar diferentes bases para executar políticas públicas.
O relatório cita situações práticas em que essa fragmentação pode fazer diferença. Em uma resposta a desastre, por exemplo, informações meteorológicas poderiam ser combinadas com dados de transportes e infraestrutura de telecomunicações. Serviços públicos poderiam cruzar informações mantidas em diferentes programas para antecipar necessidades e entregar benefícios. Órgãos também poderiam compartilhar informações e análises sem necessariamente duplicar ou movimentar dados sensíveis.
Brasil já adota modelo
“Agências governamentais não têm um problema de IA; elas têm um problema de acesso a dados”, afirma Dario Perez, executivo da Cloudera responsável pelas áreas Federal Civilian e SLED. Segundo ele, a discussão também atinge a arquitetura tecnológica utilizada pelos governos.
No documento específico para o setor público é questionada a estratégia tradicional de concentrar informações em um único ambiente. Segundo a Cloudera, transportar grandes volumes de dados para uma plataforma central pode acrescentar riscos, custos e complexidade em ambientes governamentais altamente distribuídos e regulados.
A alternativa defendida pela companhia é uma arquitetura federada, na qual aplicações e sistemas de inteligência artificial possam acessar e analisar dados onde eles já estão armazenados, sem exigir necessariamente sua transferência para um repositório central. A proposta permitiria preservar as regras de governança de cada ambiente e, ao mesmo tempo, ampliar a utilização das informações.
Essa recomendação, entretanto, deve ser considerada também à luz do interesse comercial da própria Cloudera. A companhia se apresenta como fornecedora de uma plataforma híbrida de dados e inteligência artificial destinada justamente a integrar informações mantidas em nuvens públicas, data centers próprios e ambientes de edge computing.
Porém, a proposta da companhia não está distante daquilo que o governo brasileiro já vem fazendo através do Ministério da Gestão e Inovação em Serviços Públicos (MGI). A lógica defendida pela Cloudera já encontra paralelo na “Infraestrutura Nacional de Dados (IND)”.
Instituída em 2024, a IND não foi concebida simplesmente como um grande repositório destinado a concentrar todas as bases mantidas pela administração pública. O modelo reúne regras de governança, padrões, arquiteturas e ferramentas tecnológicas para permitir que informações mantidas em diferentes órgãos e sistemas possam ser descobertas, acessadas e utilizadas de forma interoperável e segura.
Um dos instrumentos dessa estratégia é o Conecta gov.br, programa voltado à troca automática e segura de dados entre sistemas da administração pública. A IND também trabalha com os chamados “Registros de Referência”, que podem reunir informações centralizadas ou descentralizadas e provenientes de diferentes fontes. a inteligência artificial, ao lado de governança, interoperabilidade, catálogo de dados, privacidade e segurança, também integra os eixos da infraestrutura nacional.
Há, portanto, uma aproximação entre o problema identificado pelo estudo e a arquitetura que o Brasil já vem desenvolvendo. Em vez de partir da premissa de que todas as informações precisam ser copiadas ou transferidas para um único repositório antes de serem utilizadas, a interoperabilidade permite que diferentes sistemas consultem e compartilhem dados mantidos por outros órgãos, respeitadas as regras de acesso, segurança e governança.
A comparação, porém, não é absoluta. A Cloudera propõe especificamente uma arquitetura federada capaz de levar aplicações analíticas e de inteligência artificial até os dados, evitando, quando possível, sua movimentação entre ambientes. A IND brasileira tem alcance mais amplo: é uma infraestrutura de governança e interoperabilidade destinada a organizar o uso e o compartilhamento de dados na administração pública.
O diagnóstico internacional acaba, assim, colocando à prova uma questão que já está na agenda brasileira. Se o principal obstáculo à expansão da inteligência artificial no setor público não é apenas possuir ou proteger dados, mas conseguir localizá-los, acessá-los e combiná-los, o avanço da IA no governo brasileiro dependerá também da capacidade da Infraestrutura Nacional de Dados de transformar a interoperabilidade prevista em sua arquitetura em integração efetiva entre as bases e sistemas mantidos pelos diferentes órgãos.
Acesso aos dados é a chave
Ainda assim, os números da pesquisa colocam uma questão relevante para governos que estão acelerando investimentos em inteligência artificial: a infraestrutura necessária para IA não se resume à capacidade computacional. A adoção em escala depende também da capacidade de fazer diferentes sistemas conversarem, identificar onde estão as informações, estabelecer regras de acesso e garantir qualidade suficiente para que os modelos trabalhem sobre conjuntos completos e confiáveis de dados.
O levantamento não permite concluir que os mesmos percentuais sejam encontrados especificamente no governo brasileiro. O levantamento foi realizado pela Researchscape, a pedido da Cloudera, com 1.270 líderes de TI de organizações com mais de mil funcionários nas Américas, Europa, Oriente Médio, África e Ásia-Pacífico, entre janeiro e março de 2026. Os resultados foram ponderados de acordo com o PIB dos países pesquisados. A empresa, porém, não informa quantos dos entrevistados pertencem especificamente ao setor público nem apresenta a distribuição dessa amostra por país, o que impede medir o peso de cada mercado nos indicadores do segmento.
Mas o diagnóstico internacional coloca uma pergunta que antecede boa parte do debate sobre inteligência artificial no setor público: antes de decidir qual IA utilizar, onde contratar capacidade computacional ou em qual nuvem executar os modelos, os governos precisam saber se suas máquinas conseguirão chegar aos dados de que necessitam.
O desafio deixa, portanto, de ser apenas proteger informações públicas. A pesquisa indica que o próximo passo é conseguir utilizá-las sem desmontar justamente os mecanismos de segurança e governança construídos para protegê-las. No setor público, a disputa pela inteligência artificial pode começar menos no algoritmo e mais na capacidade de conectar aquilo que o Estado já possui.